意味不明すぎて嫌気が差してきた
うわ、最悪すぎるな
Tora  さんがブースト

あ、そういうつながり
Tora
さんがブースト
さんがブースト

 ITmedia NEWS 最新記事一覧
ニッスイ子会社で入出荷停止 IDCFクラウド影響か 委託先データセンターに不正アクセス
https://www.itmedia.co.jp/news/article/2610/08/2000002113/
半袖で出てきてしまい、ぶっちゃけ寒い
EV、やっぱりタイヤすり減るの速いのかなぁ。アホみたいな加速で遊んでるからだとは思うんだけど、減ってる気はするなぁ。
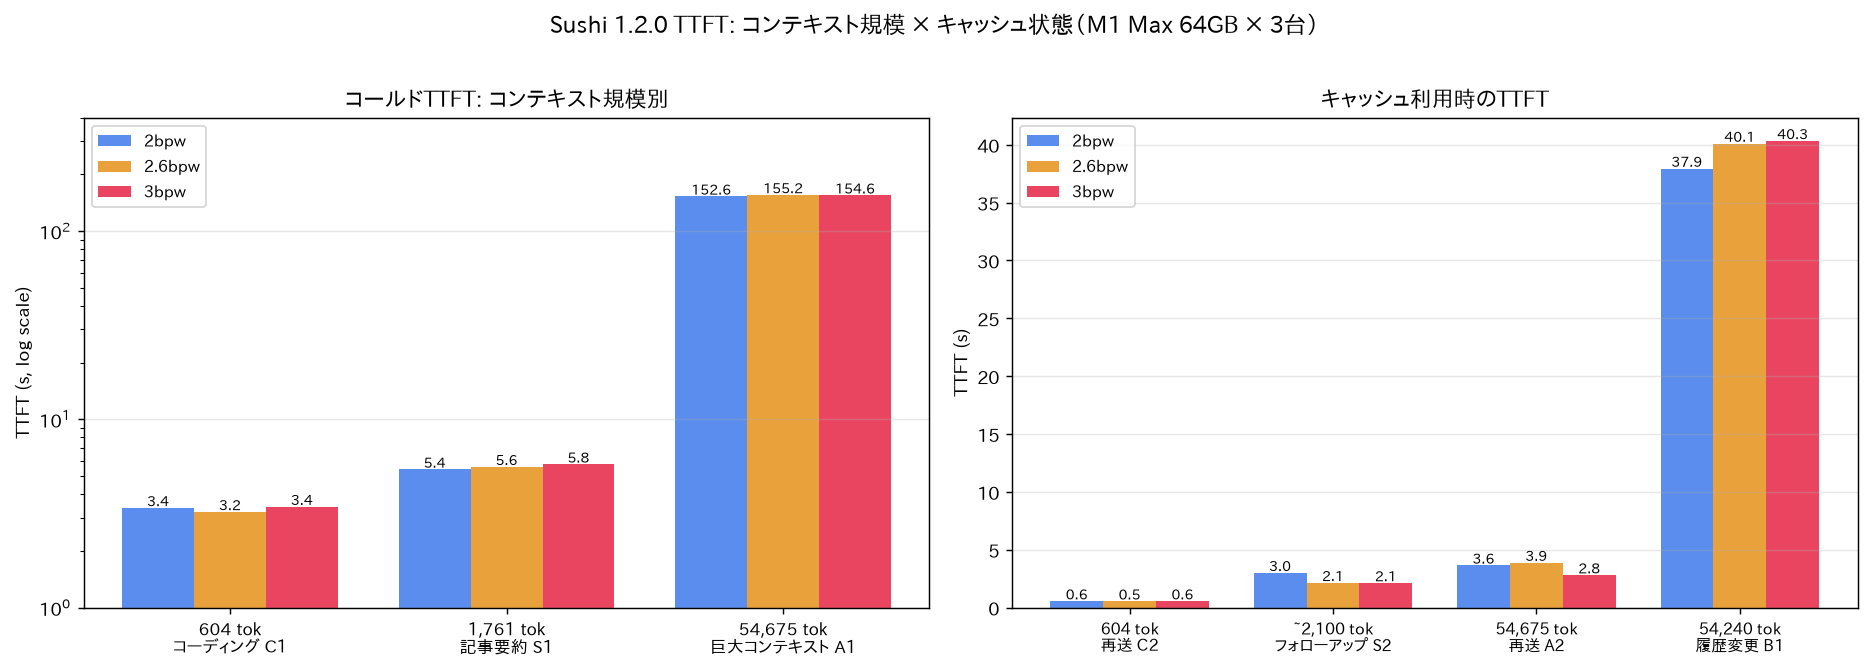
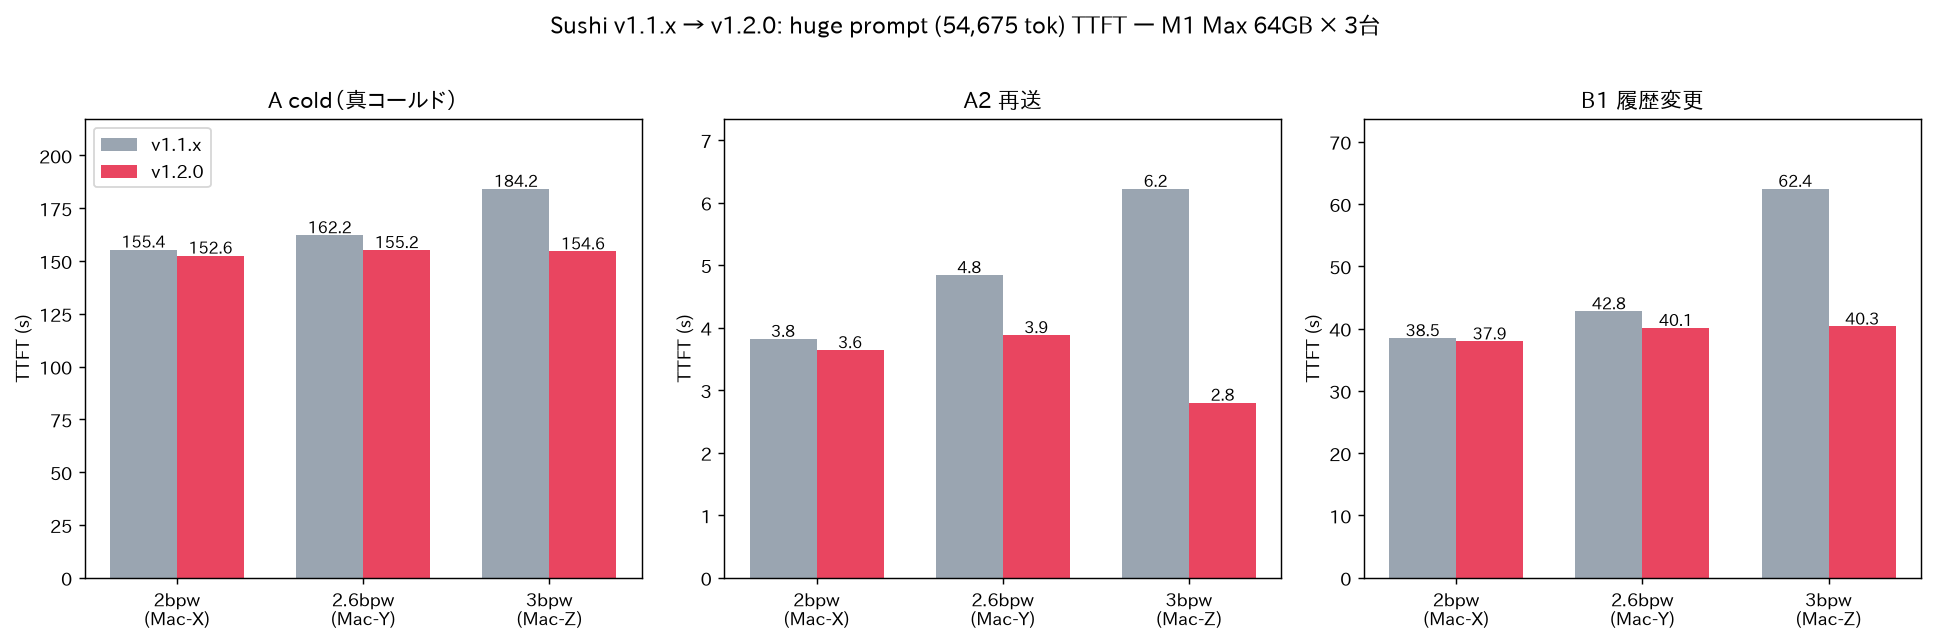
巨大プロンプトなんてエージェントハーネスじゃないと突っ込まないんだから、もっと少なくしてベンチを取る必要があるな。そもそもこれは品質をテストしていないのでちょっとアレ。
Sushi 1.1 と 1.2 比較
Qwen 3.8 Flash Next(80B)
64GB M1Max
巨大プロンプトを突っ込んでこれ。ひと昔前のランタイムじゃそもそも動かなかったから、かなり凄い。
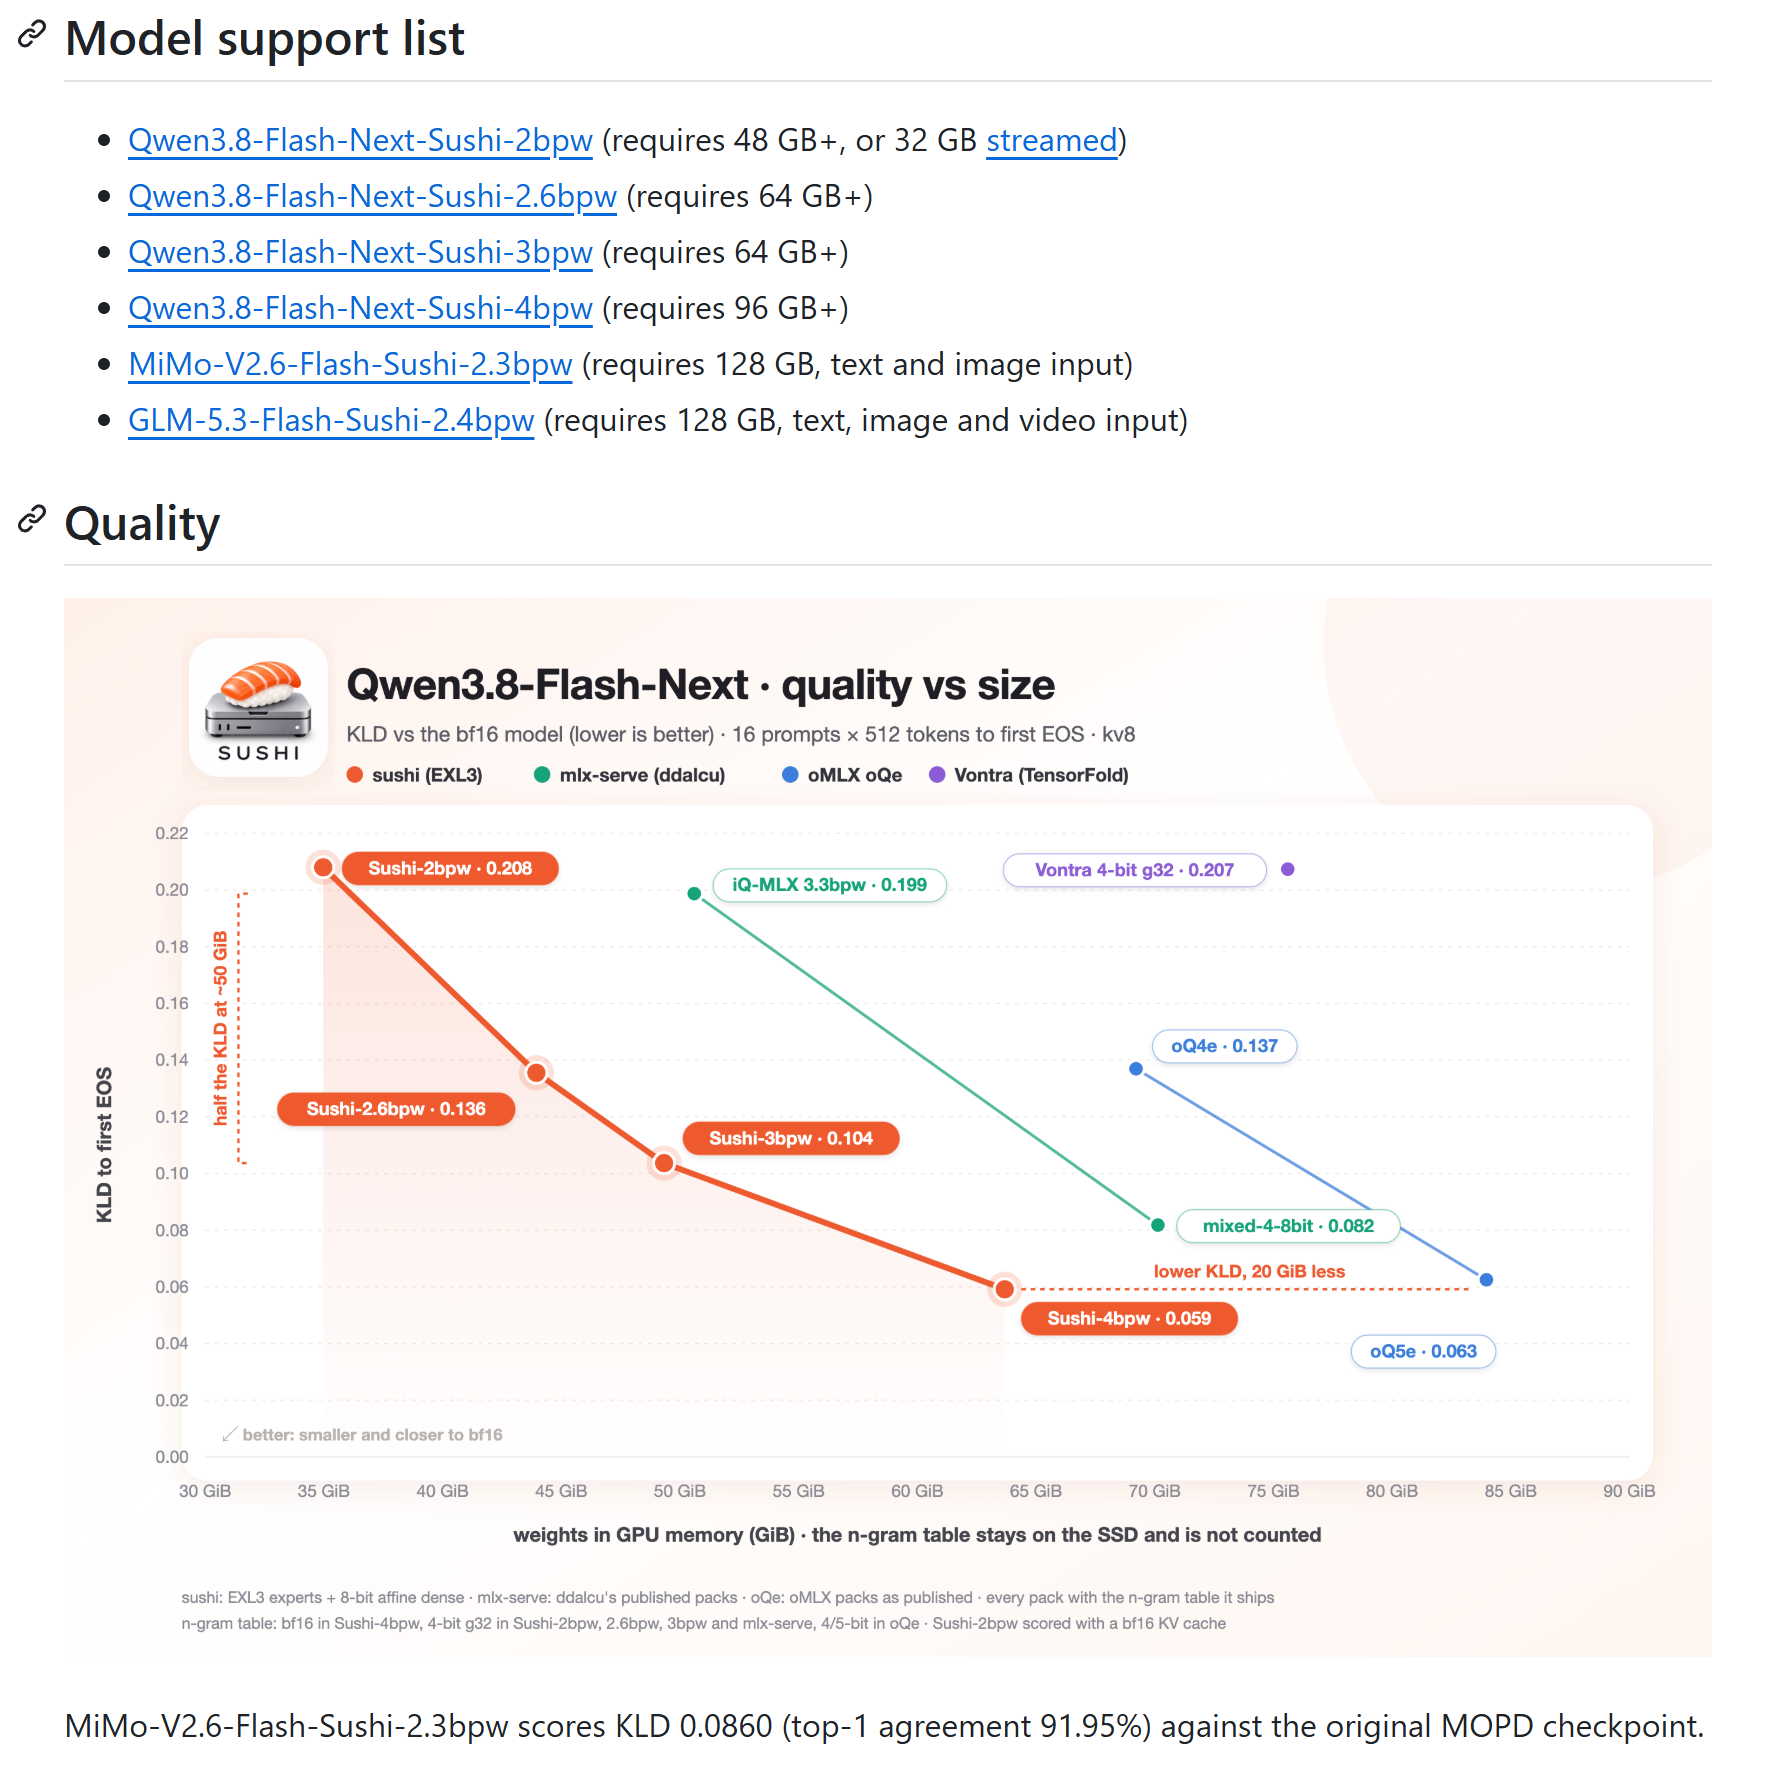
Sushi は、メモリの大きくない Mac で巨大 LLM をそれなりに動かすことができるチートランタイムです。
https://github.com/beamivalice/sushi
(快適とは言っていない)
Sushi ランタイムの話では、十分の基準がどうも 128GB。貧弱の基準が32GB。16GBは相手にされてない。
AIを快適に動かす話をしているので基準はお察しください。
Tora
さんがブースト
さんがブースト
ローカルLLMでAI利用料不要
→広義の意味では事実
(300万円のMacStudioなら)
Tora
さんがブースト
さんがブースト
ローカルLLMが動かせるパソコンをAI利用料不要って言うのはどうなんだって思ったけど、まあ新聞記事だから今更だな。
ねむいね。