なにこれ?って思ったら、
これは **ホテル・旅館向けの「サイトコントローラー」**です。かなり重要な位置にいるシステムですね。
だって。
---
手間いらずの「TEMAIRAZU」シリーズへの不正アクセスについてまとめてみた - piyolog -
https://piyolog.hatenadiary.jp/entry/2026/09/30/013735
忘れてた。返品作業しなきゃ。
うーわ、悲惨
---
Pyron (@GabrielPyron) on X
ポルトガル語からの翻訳
SEGAやゲームの権利を持つ他の保有者のライセンスなしで、SteamでWonderboyの再コンパイル版を売っているようです。
彼らは詐欺師の新しいレベルに達しました、そして最悪なのは、すでに10k以上のコピーを売ってしまったことです。
ねむいね。
おかしいなぁ。X で LLM の情報収集したいのに、変な自慢話ばっかり流れてくるようになった。「なんで年上に教えてやらないといけないの」「会社なんかどうでもいい」って。じゃあ起業すればええやん。
Google が迷惑電話と断定したので
080-9201-9834
070-4210-4813
Qwen Next 凄いな。巨大プロンプトでもキャッシュが効くぞ。(キャッシュが効くというだけで遅いマシンだとやっぱり速くはない。)
80BモデルのB1で部分再利用が発動: cached=32,768/52,094トークン(62%)→ TTFT 58.3秒(コールド122.8秒の-53%)。80BはKVキャッシュのトークンあたりサイズが小さい(ハイブリッド線形注意のQwen3-Nextアーキテクチャ)ため、共通プレフィックスがキャッシュ単位に収まり、radix部分一致が実動作しました。一方gpt-oss-20bでは同じB1がフルprefillだったのと対照的です。
面白すぎるけどそれでこそエンジニアって感じするw
Tora  さんがブースト

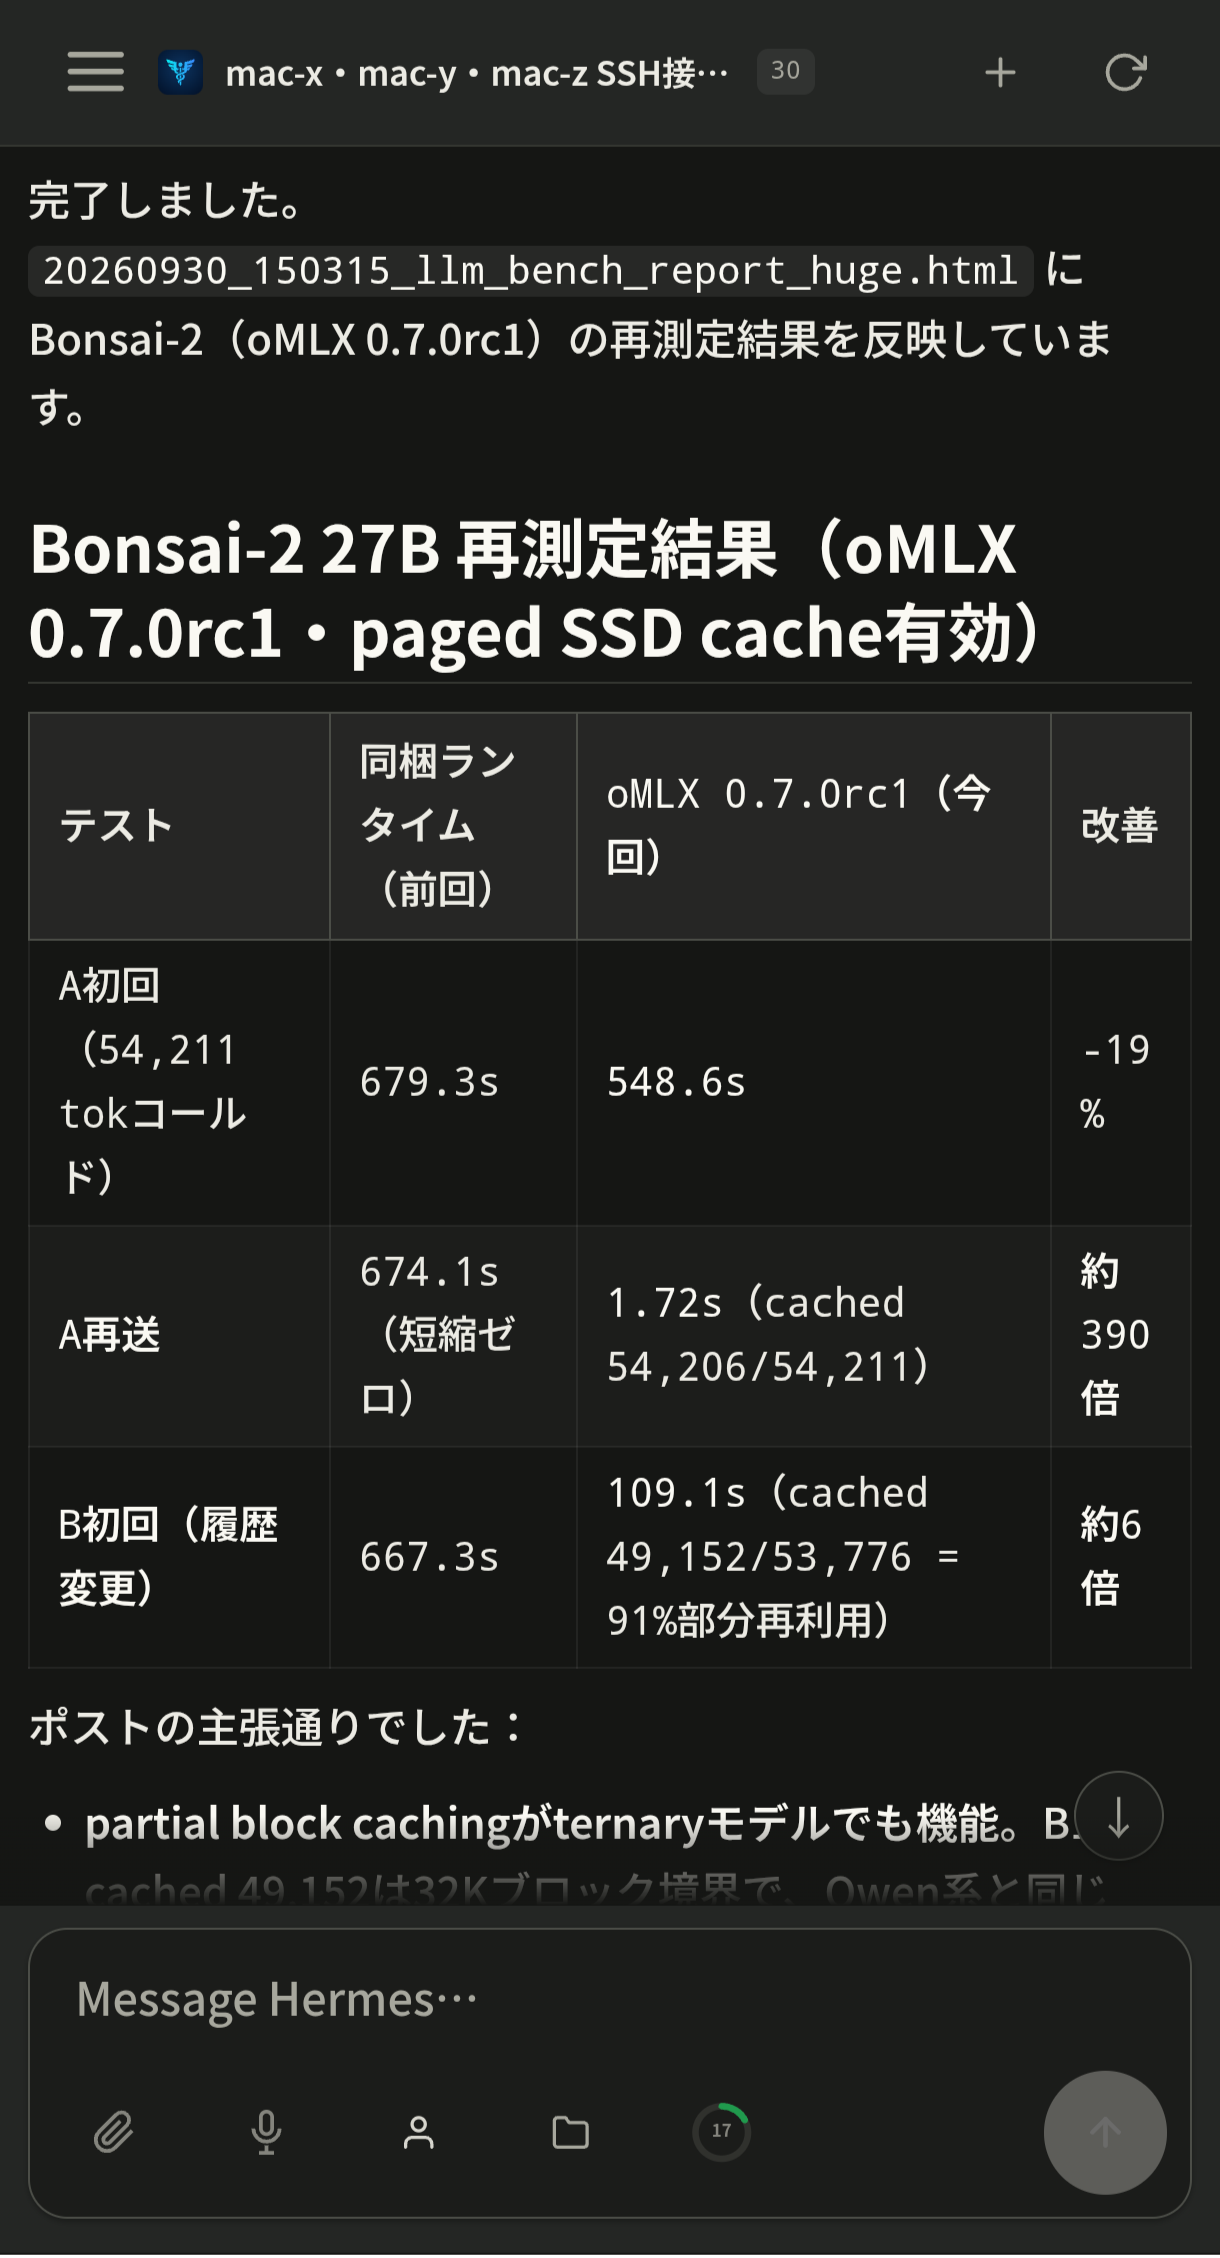
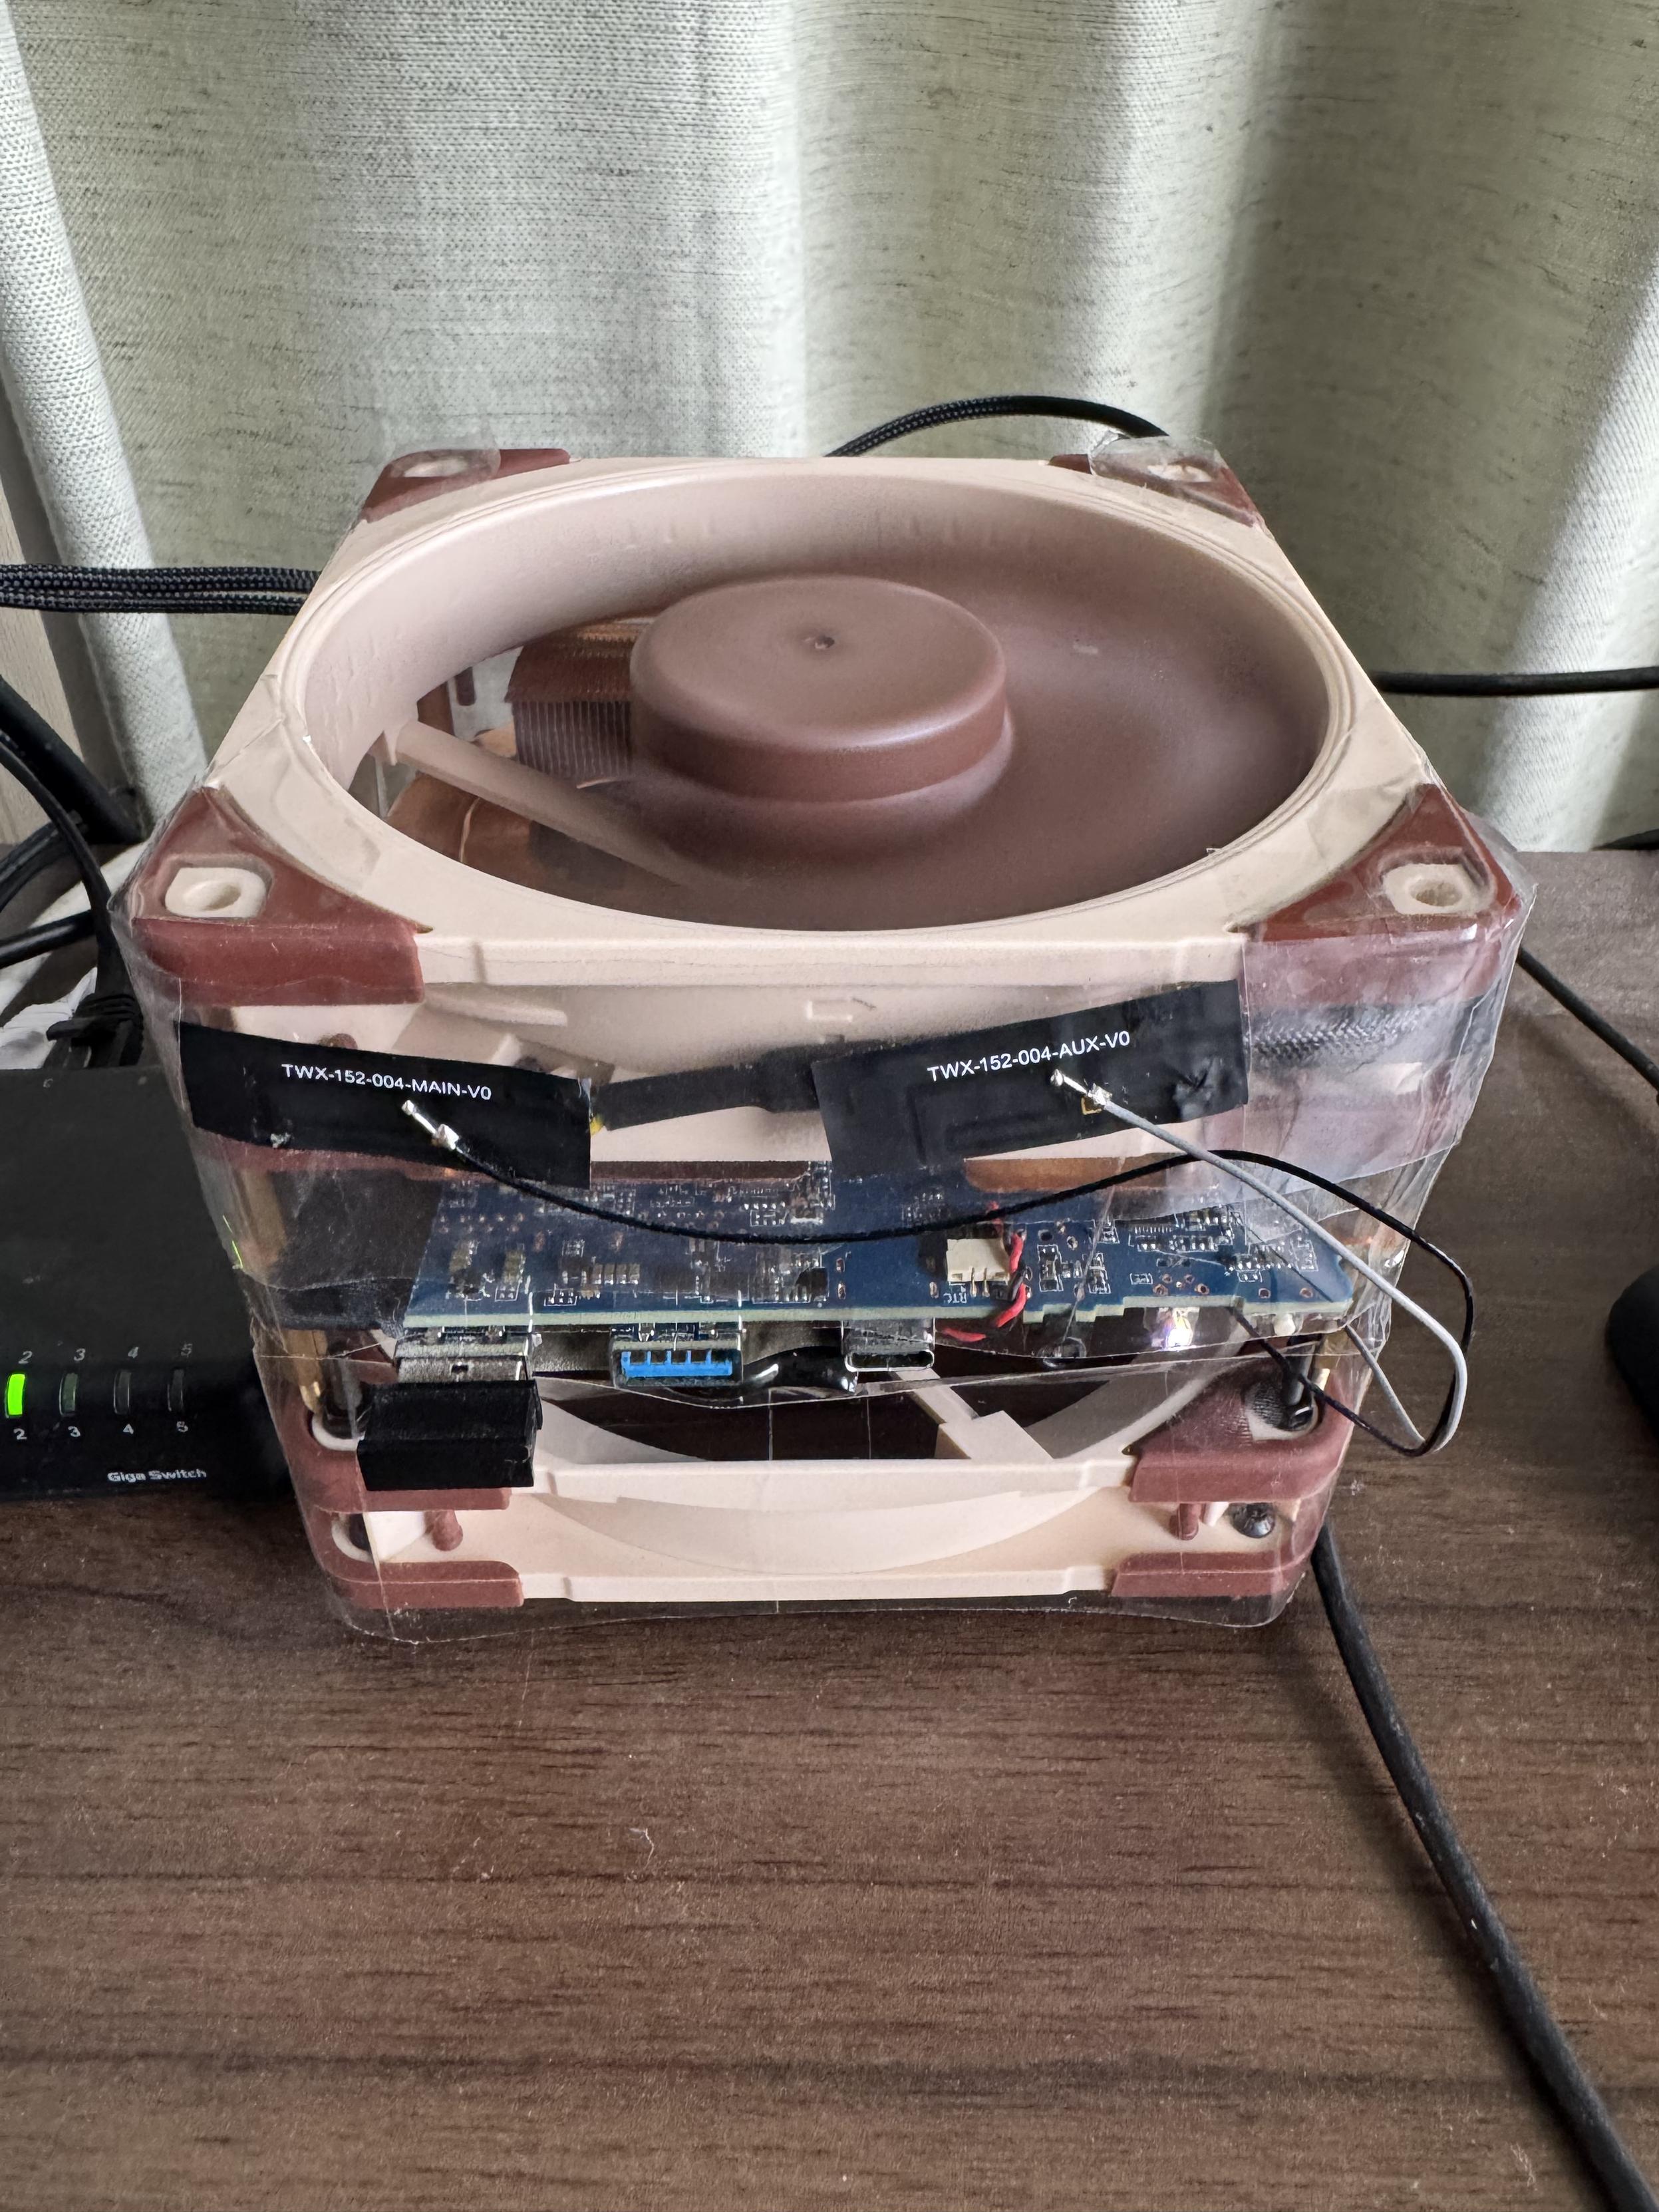
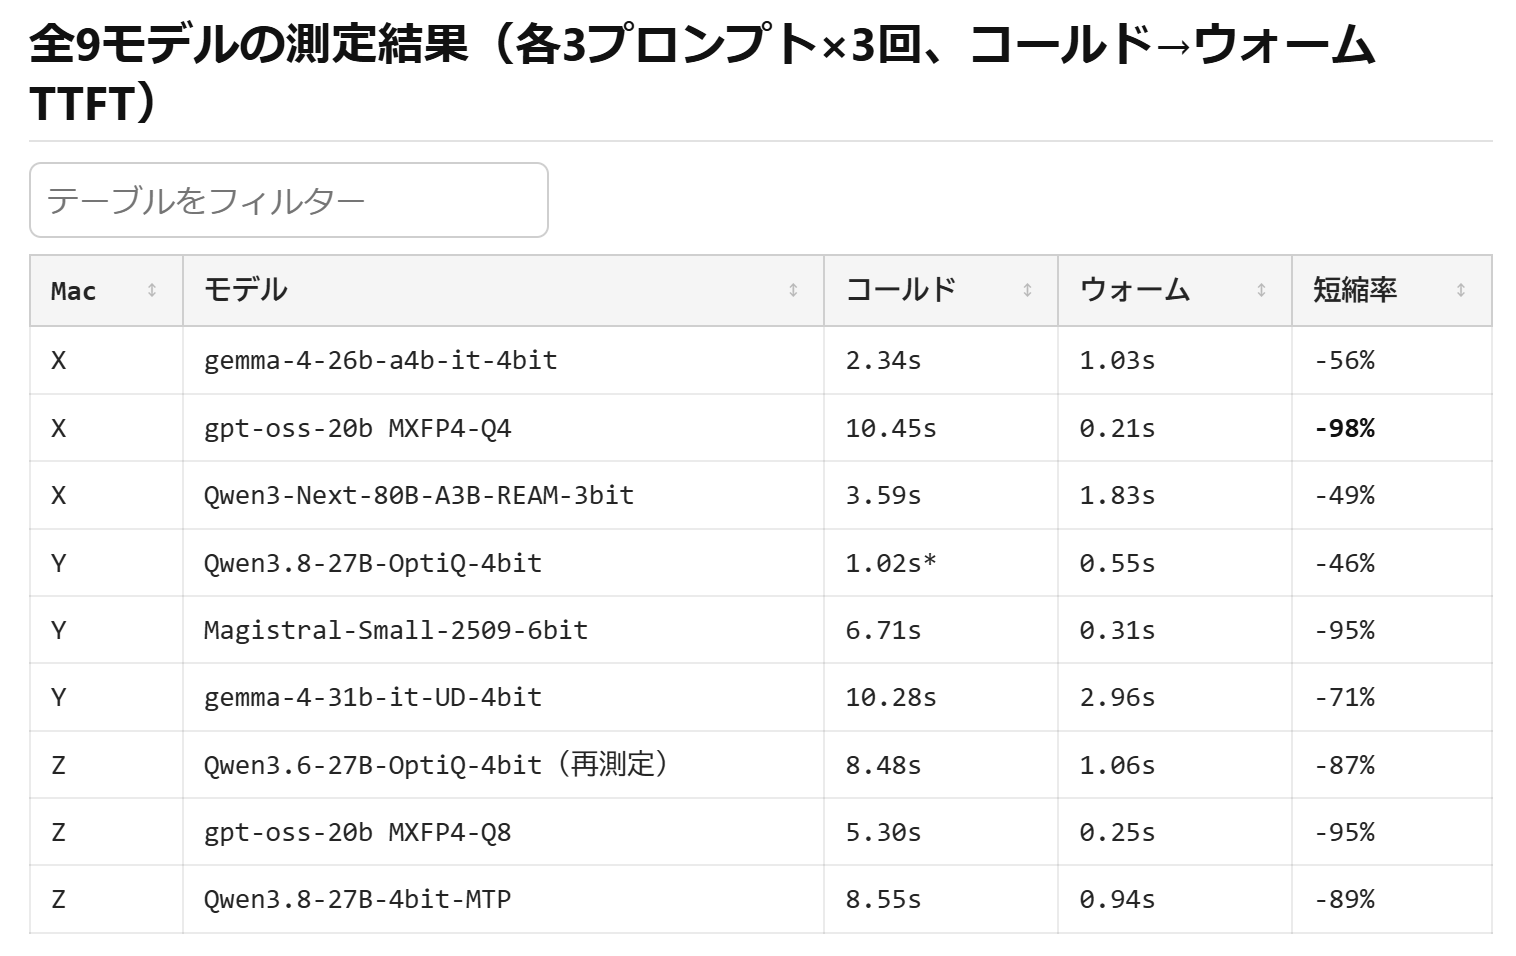
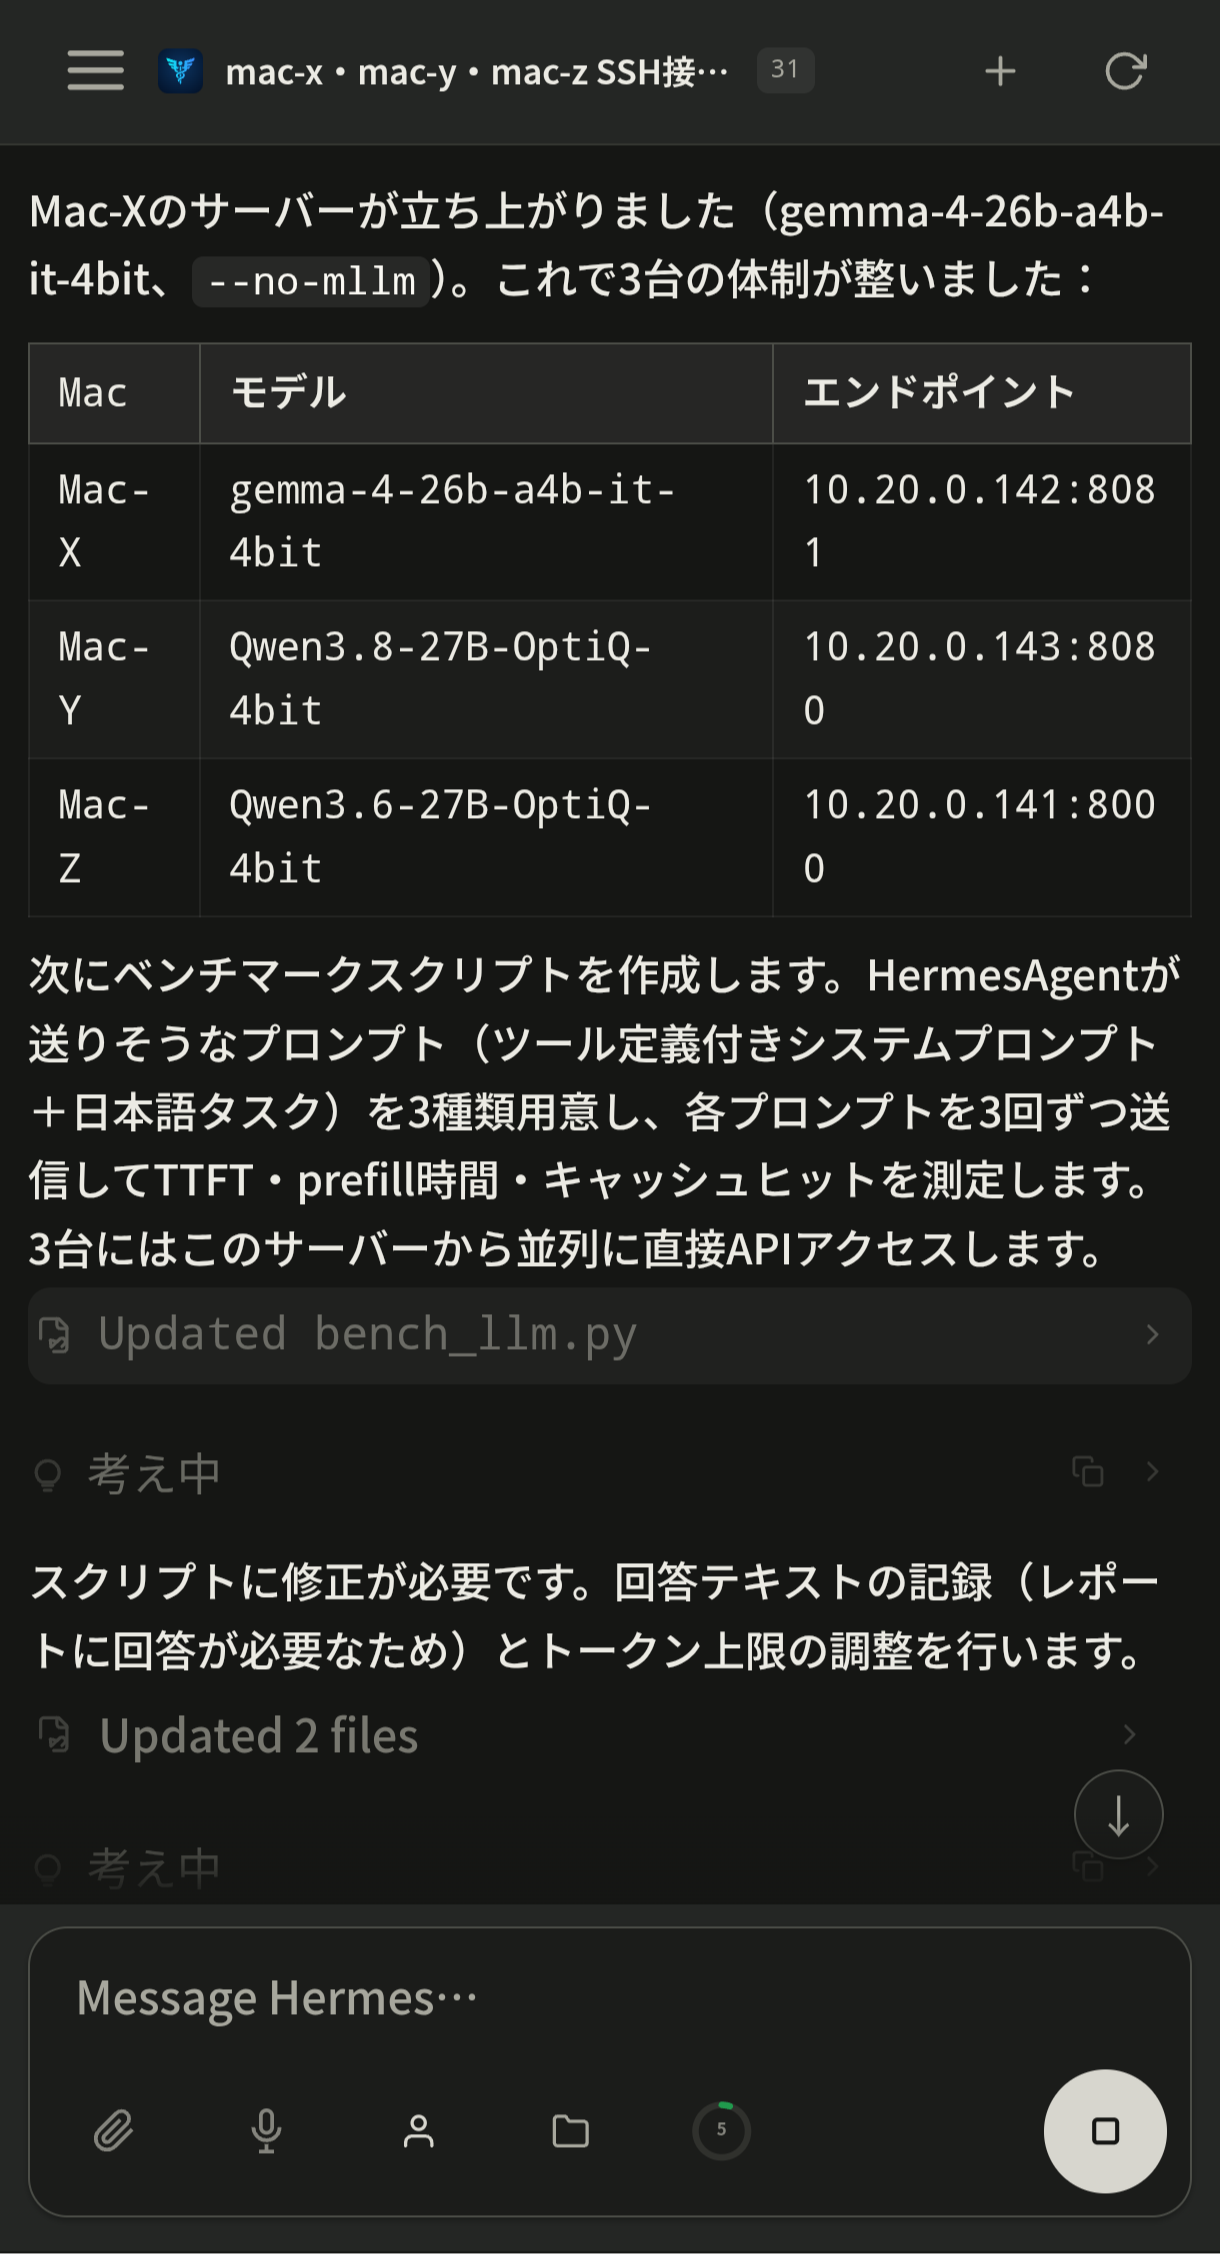
もう Z.ai のトークンが余って余って仕方がないから、3 台の Mac を使ってどれが一番速いか HermesAgent (Z.ai / GLM 5.3 Flash)にテストさせるっていうのをやってる。