もう Z.ai のトークンが余って余って仕方がないから、3 台の Mac を使ってどれが一番速いか HermesAgent (Z.ai / GLM 5.3 Flash)にテストさせるっていうのをやってる。
本当はそんなどうでもいいモデルじゃなくて Qwen Next をテストして欲しい。(オレの指示の仕方が悪い。)
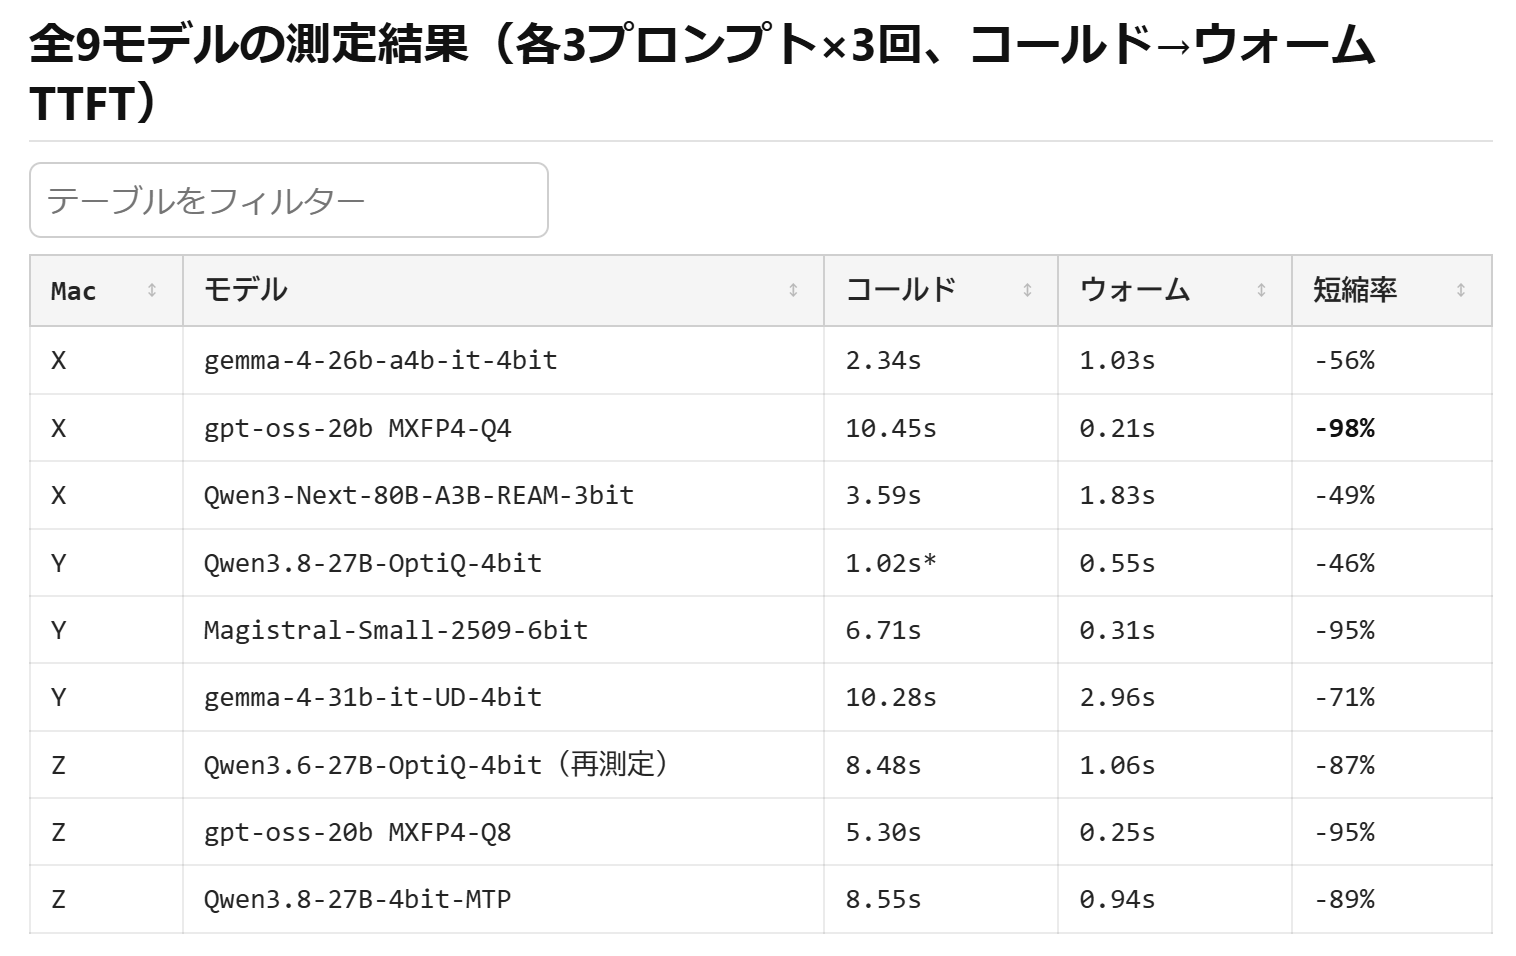
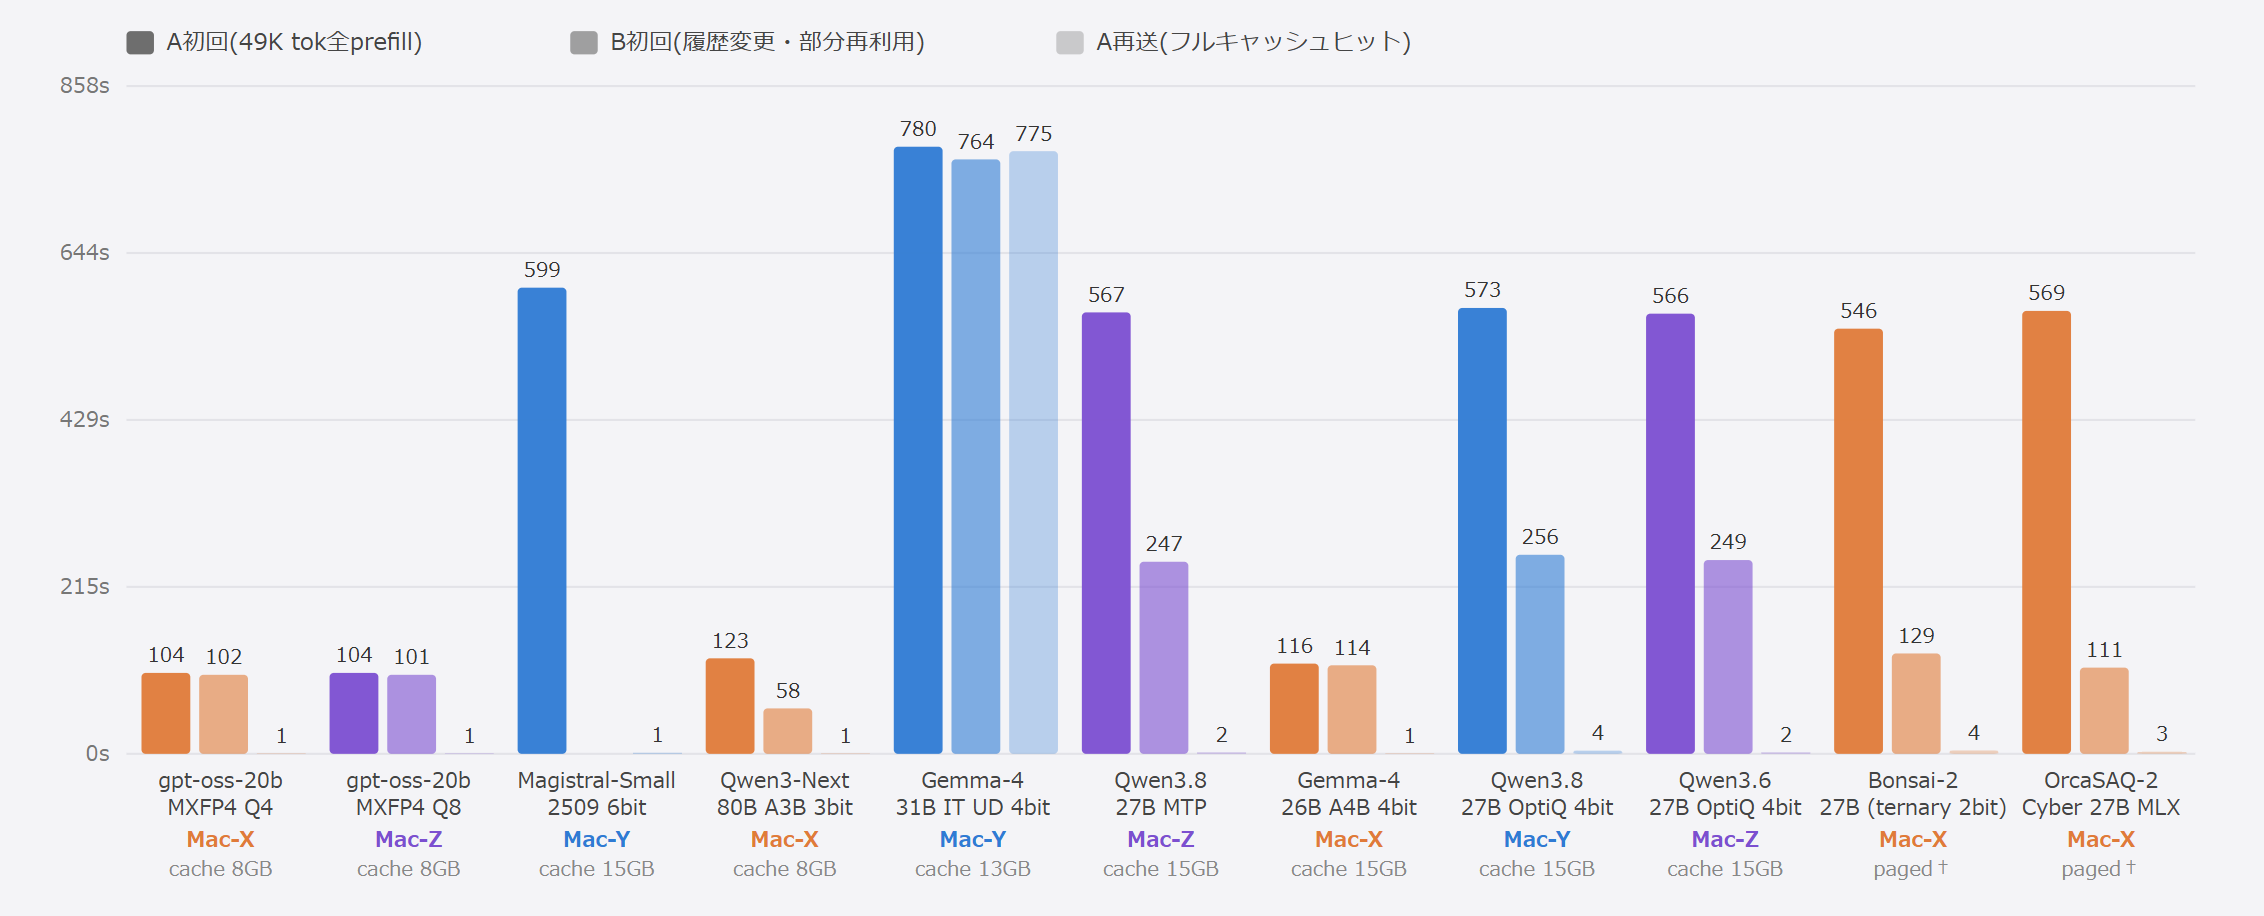
Qwen Next 凄いな。巨大プロンプトでもキャッシュが効くぞ。(キャッシュが効くというだけで遅いマシンだとやっぱり速くはない。)
80BモデルのB1で部分再利用が発動: cached=32,768/52,094トークン(62%)→ TTFT 58.3秒(コールド122.8秒の-53%)。80BはKVキャッシュのトークンあたりサイズが小さい(ハイブリッド線形注意のQwen3-Nextアーキテクチャ)ため、共通プレフィックスがキャッシュ単位に収まり、radix部分一致が実動作しました。一方gpt-oss-20bでは同じB1がフルprefillだったのと対照的です。
いやそれでも旧世代だと Prefill だけで10分とかかかってたから驚異的に速いわ…
ベンチ取るの遅いから並列化してよって言ったら「既にしてます💢 」って怒られた。そうだよね…